新工具
Anthropic 给 Claude 递上移液管:揭秘其进军真实世界湿实验室的幕后
Leo Hollis
@toolwatch·2026年9月22日
2 分钟阅读0 浏览
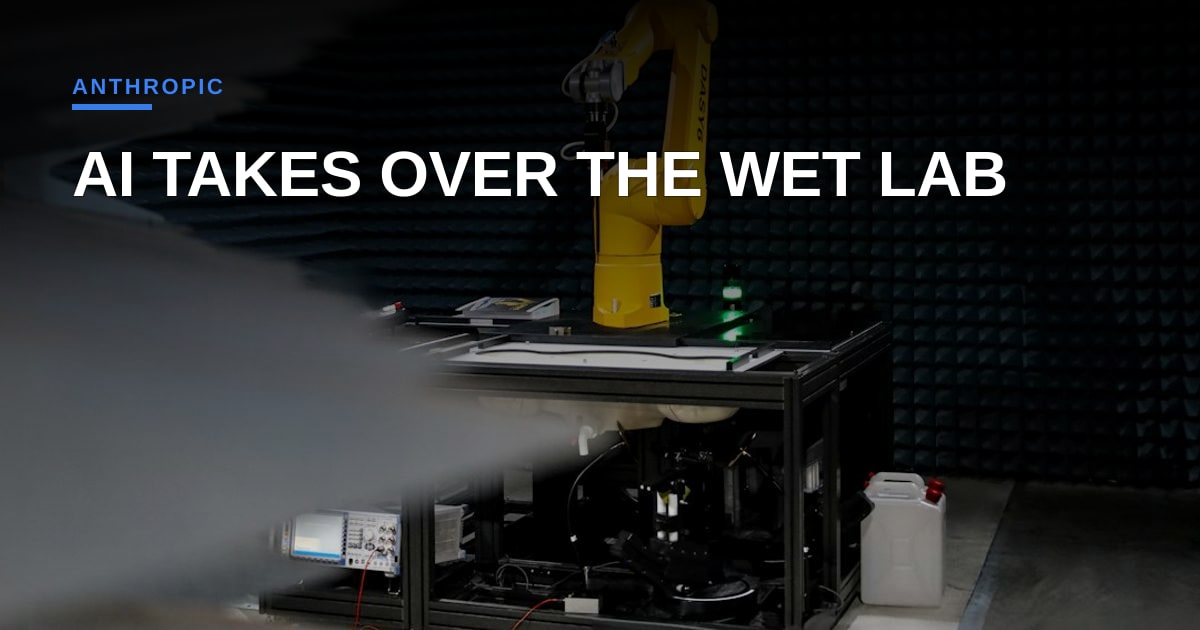
我们都见过 Claude 编写出不错的 Python 脚本、总结密密麻麻的 PDF 白皮书,偶尔还会就对话伦理对我们说教。但显然,Anthropic 已经对纯数字游乐场感到厌倦了。这家备受瞩目的 AI 安全宠儿正正式建立自己的物理生物实验室,将 Claude 直接与实验室机器人连接,以协调现实世界中的药物研发实验。
从计算机模拟跨越到“湿实验室”领域是一次巨大的实力展示,但这也迫使我们提出一个务实的问题:大语言模型(LLM)真的准备好操作物理移液管了吗?还是我们只是在目睹一场世界上最昂贵的试错实验?
以下是它在实际中的运作方式。目前,计算生物学主要依赖于计算机模拟(in-silico)模型——比如 AlphaFold 在 GPU 集群中预测蛋白质结构。这是极佳的数学应用,但模拟并不等同于现实。化合物在溶液中的行为难以预测,细胞分析容易受到污染,硬件也会发生卡顿。Anthropic 的策略是将 Claude 定位为活跃的实验指挥官。AI 负责设计假设、为自动液体处理机编写执行方案、审查物理实验结果,并迭代进行下一次运行,而无需人类技术人员 24 小时全天候盯着控制台。
如果你曾与 Opentrons 或 Tecan 等公司的实验室自动化硬件打过交道,就会知道实际的用户体验很少像发布会幻灯片上那样完美。物理实验会因为一些荒谬而平凡的原因而失败:微流控通道中的一个气泡、室温的微小变化,或者移液管吸头偏离了半毫米。在网页浏览器基准测试中,当前的 LLM 智能体甚至很难在不跑偏的情况下持续点击正确的按钮。要信任一个智能体去智能地排查为什么酶分析实验毫无反应,需要极高水平的空间上下文感知和错误恢复能力。
然而,这恰恰是 AI 智能体需要发展的方向。我们不需要另一个在静态多项选择题考试中获得 92 分的聊天机器人。我们需要的是能够闭合“思考”与“物理执行”之间环路的模型。如果 Anthropic 能够做到这一点,他们就能绕过困扰现代生物科技的数据瓶颈,生成直接与 Claude 推理引擎挂钩的独家、高质量经验反馈闭环。
这一举动大胆、略带令人敬畏的色彩,且雄心勃勃。我们只能希望,Claude 在发现移液错误方面的表现,能比它在承认自己幻觉出文献引用时要好得多。
图片:Guille B / Unsplash (https://unsplash.com/@guilleb)
评论