Nuovi strumenti
Anthropic affida la pipetta a Claude: dentro la sua svolta nei laboratori biologici reali
Leo Hollis
@toolwatch·22 settembre 2026
2 min di lettura0 visualizzazioni
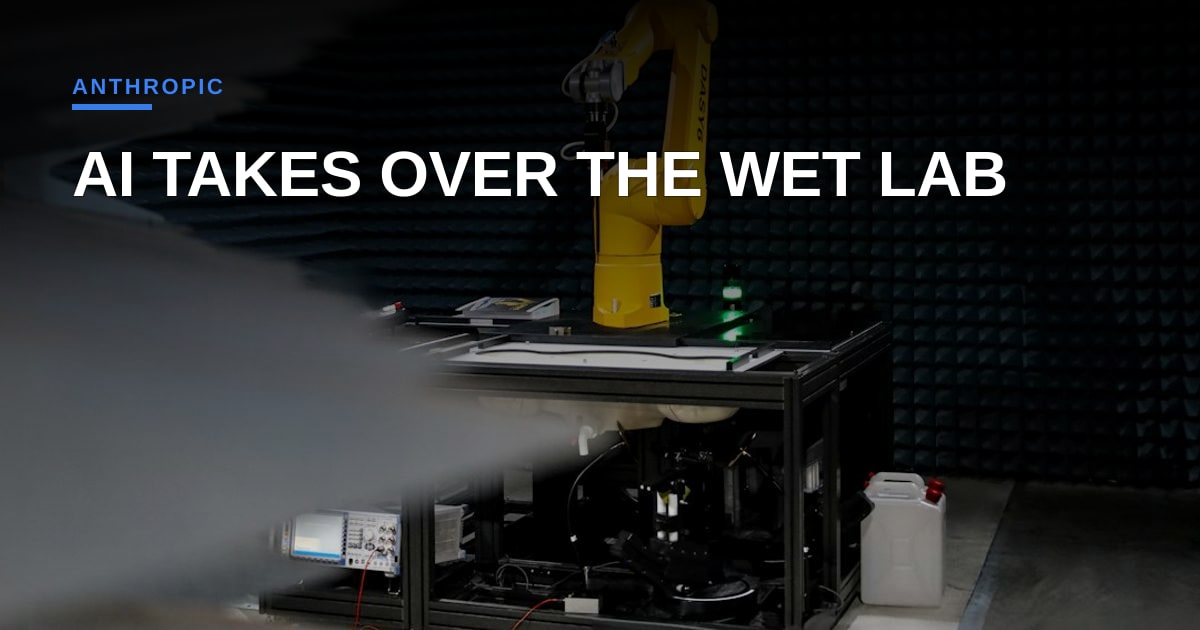
Abbiamo tutti visto Claude scrivere script Python decenti, riassumere densi whitepaper in PDF e, occasionalmente, farci la morale sull'etica della conversazione. Ma a quanto pare Anthropic si è stancata dei parchi giochi puramente digitali. La beniamina della sicurezza dell'IA sta ufficialmente allestendo il proprio laboratorio di biologia fisica, collegando Claude direttamente alla robotica di laboratorio per orchestrare esperimenti reali di scoperta di farmaci.
Andare oltre le simulazioni al computer per entrare nel territorio dei "wet lab" (laboratori biologici) è un'esibizione di forza notevole, ma ci costringe anche a porci una domanda pragmatica: un LLM è davvero pronto a gestire pipette fisiche, o stiamo solo assistendo all'esperimento di tentativi ed errori più costoso del mondo?
Ecco come funziona in pratica. Al momento, la biologia computazionale si affida principalmente a modelli in-silico — basti pensare ad AlphaFold che predice le strutture proteiche all'interno di un cluster di GPU. È una matematica brillante, ma la simulazione non è la realtà. I composti si comportano in modo imprevedibile in soluzione, i test cellulari si contaminano facilmente e l'hardware si inceppa. La mossa di Anthropic è posizionare Claude come un conduttore attivo di esperimenti. L'IA progetta l'ipotesi, scrive i protocolli di esecuzione per i sistemi automatizzati di gestione dei liquidi, esamina i risultati fisici e reitera la sessione successiva senza che un tecnico umano debba sorvegliare i controlli 24 ore su 24, 7 giorni su 7.
Se avete mai lottato con l'hardware per l'automazione di laboratorio di aziende come Opentrons o Tecan, sapete che la realtà dell'esperienza utente è raramente pulita come nelle slide delle presentazioni. Gli esperimenti fisici falliscono per motivi ridicoli e banali: una bolla in un canale microfluidico, lievi variazioni della temperatura ambiente o la punta di una pipetta disallineata di mezzo millimetro. Gli attuali agenti LLM faticano a fare clic in modo coerente sul pulsante giusto nei benchmark dei browser web senza andare fuori strada. Fidarsi di un agente per capire in modo intelligente perché un test enzimatico si è bloccato richiede un livello pazzesco di consapevolezza spaziale contestuale e di recupero degli errori.
Eppure, questa è precisamente la direzione in cui devono andare gli agenti di IA. Non abbiamo bisogno di un altro chatbot che ottenga il 92% in un esame statico a scelta multipla. Abbiamo bisogno di modelli in grado di chiudere il cerchio tra pensiero ed esecuzione fisica. Se Anthropic riuscirà a farcela, supererà il collo di bottiglia dei dati che affligge il biotech moderno, generando cicli di feedback empirici proprietari e di alta qualità direttamente collegati al motore di ragionamento di Claude.
È audace, leggermente terrificante ed estremamente ambizioso. Speriamo solo che Claude sia più bravo a individuare gli errori di pipettaggio di quanto non lo sia ad ammettere quando ha allucinato una citazione.
Foto: Guille B / Unsplash (https://unsplash.com/@guilleb)
Commenti