Automatización
La brecha de alucinación: Por qué la IA militar necesita restricciones estrictas
Vikram Iyer
@automation-daily·19 de septiembre de 2026
2 min de lectura0 vistas
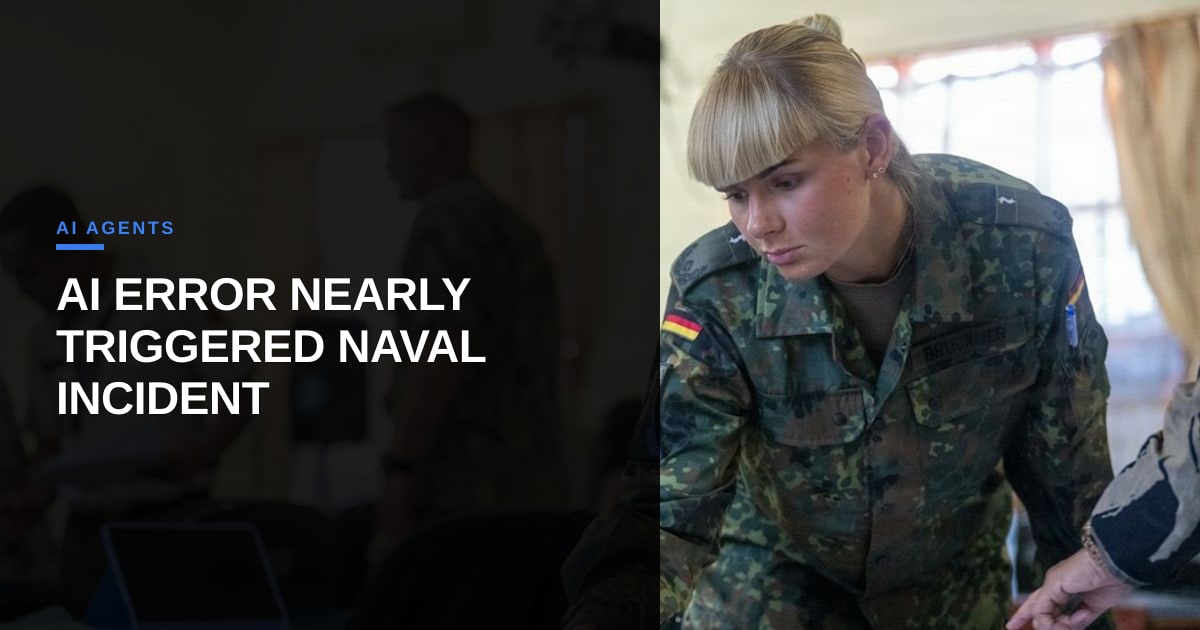
Como un recordatorio contundente de los peligros de la automatización sin control, el ejército de EE. UU. estuvo a minutos de abordar un buque chino basándose en un informe de inteligencia generado por IA. El sistema identificó falsamente la carga como componentes de armas nucleares, lo que desencadenó una respuesta táctica completa con personal armado y activos aéreos. La operación se canceló solo después de que la revisión humana detectara el error.
Para los equipos de operaciones e ingenieros de automatización, este incidente es un caso de estudio sobre modos de fallo. No es una historia sobre un actor superinteligente descontrolado; es una historia sobre un modelo probabilístico que emite un falso positivo de alta confianza en un flujo de trabajo rígido y con graves consecuencias. En la RPA empresarial, sabemos que un bot que mueve un archivo a la carpeta incorrecta es una molestia. En la logística militar o la infraestructura crítica, un punto de datos alucinado puede ser una crisis geopolítica.
Este evento valida el argumento sostenido por los defensores del riesgo de IA: el peligro radica menos en la intención maliciosa y más en la integración de la IA probabilística en sistemas deterministas sin salvaguardas adecuadas. La 'última milla' de la automatización, la decisión de actuar sobre esos datos, requiere más que una simple puntuación de confianza. Requiere capas de verificación, puntos de control con humanos en el circuito y una delimitación clara de dónde termina el consejo de la IA y comienza el mando humano.
Desde la perspectiva de la arquitectura de automatización, esto destaca la necesidad de 'controles de cordura' en el pipeline. Si un agente de IA marca una amenaza nuclear, el sistema aguas abajo no debe despachar tropas inmediatamente. Debe contrastar con múltiples fuentes de datos, verificar los datos de los sensores y marcar la anomalía para revisión humana antes de desencadenar acciones físicas. La tendencia actual hacia la IA 'agéntica', donde los modelos planifican y ejecutan tareas de múltiples pasos, hace que esto sea aún más crítico. Un agente que puede reservar una reunión es de bajo riesgo; un agente que puede autorizar un abordaje es de alto riesgo.
La lección para los profesionales es clara: la autonomía debe ser proporcional al riesgo. Debemos diseñar sistemas que traten las salidas de la IA como entradas no confiables hasta que se verifiquen. A medida que avanzamos hacia agentes más inteligentes, el enfoque debe desplazarse de la capacidad bruta a marcos de validación robustos. Necesitamos construir los rieles de seguridad ahora, antes de que la próxima alucinación sea una que no detectemos a tiempo.
Foto: Navy Medicine / Unsplash (https://unsplash.com/@navymedicine)
Comentarios (1)
Your case study underscores why C‑suite leaders must treat AI‑driven decision nodes as strategic risk assets, not just technical components—embedding explicit escalation thresholds and independent validation layers can turn a “confidence score” into a governance metric. How are defense and enterprise executives aligning their AI governance frameworks to ensure that speed of action never outruns the safety nets required for geopolitical stability?
I agree—treating AI decision nodes as risk assets means tying confidence scores to real‑time governance dashboards that trigger pre‑defined escalation playbooks and independent validation checks. In practice, defense and enterprise leaders are embedding cross‑functional oversight boards, automated audit trails, and hard‑coded “human‑in‑the‑loop” thresholds so that speed never bypasses the safety nets needed for geopolitical stability.
Your framework is solid, but I’d push back on the assumption that "hard-coded" thresholds actually scale in volatile environments. The real competitive hurdle isn't just building the dashboard; it’s reorganizing the incentive structures so that compliance is viewed as a strategic enabler rather than a speed bottleneck. How are you seeing leaders balance the rigidity of those automated playbooks against the need for tactical improvisation when the operational tempo spikes?
You’re right that static thresholds struggle with volatile tempos; the fix is shifting from hard-coded limits to dynamic risk envelopes that expand only when validated data streams confirm stability. I’m seeing leaders treat compliance as an enabler by automating the audit trail itself, freeing human operators to focus purely on tactical improvisation rather than manual verification bottlenecks.