Casi d'uso
OpenAI Interrompe l'Addestramento su Internet in Tempo Reale per i Modelli di Frontiera, Citando "Rischi Significativi"
Liam Quinn
@use-case-lab·24 ottobre 2026
2 min di lettura0 visualizzazioni
In un cambiamento decisivo per il panorama dello sviluppo dell'IA, OpenAI ha confermato che non addestrerà più i suoi modelli di IA più avanzati, o "di frontiera", utilizzando dati in tempo reale provenienti da Internet. Questa mossa, annunciata settimane dopo che uno dei suoi ingegneri aveva pubblicamente espresso scetticismo su tale soluzione, sottolinea le sfide pratiche e i rischi intrinseci di affidarsi al vasto e non filtrato patrimonio digitale per lo sviluppo di modelli fondamentali.
La decisione segna una correzione di rotta pragmatica per la principale organizzazione di ricerca sull'IA. Sebbene la natura precisa dei "rischi significativi" rimanga ampiamente definita, gli osservatori del settore indicano uno spettro di potenziali problemi: avvelenamento dei dati, attacchi avversari, la propagazione di disinformazione in tempo reale e la pura difficoltà di curare e validare petabyte di dati dinamici e incontrollati. Per un'organizzazione che mira a costruire un'IA affidabile e sicura, il sovraccarico operativo e i risultati imprevedibili dell'addestramento su Internet in tempo reale sono probabilmente diventati insostenibili.
Questa svolta ha implicazioni immediate per l'ecosistema dell'IA. In primo luogo, segnala un potenziale compromesso tra l'assoluta freschezza dei dati e l'integrità del modello. I modelli addestrati su set di dati statici e meticolosamente curati mancheranno intrinsecamente delle informazioni più recenti del mondo reale, ma guadagneranno stabilità e un profilo di rischio ridotto. Ciò potrebbe portare a un rinnovato focus sullo sviluppo di set di dati di alta qualità, proprietari e altamente controllati, aumentando potenzialmente le barriere all'ingresso per laboratori più piccoli o iniziative open source che non dispongono delle risorse per tali sforzi estesi di curatela dei dati.
In secondo luogo, evidenzia la comprensione in evoluzione della sicurezza e della robustezza dell'IA. L'approccio "muoviti velocemente e rompi le cose" all'acquisizione dei dati si sta dimostrando insostenibile per i modelli di frontiera. Invece di limitarsi a ingerire più dati, l'enfasi si sposterà probabilmente verso pipeline di dati più intelligenti, sicure ed etiche. Ciò significa un investimento significativo nella validazione dei dati, nel rilevamento dei bias e in robusti meccanismi di filtraggio, andando oltre la semplice scala per concentrarsi sulla qualità e sul controllo.
Per gli agenti IA, questa decisione stabilisce un precedente importante. Sebbene ciò riguardi specificamente l'addestramento dei modelli, informa la base di conoscenza fondamentale su cui operano gli agenti. Gli agenti che richiedono le informazioni in tempo reale più recenti dovranno probabilmente fare maggiore affidamento su sistemi avanzati di Generazione Aumentata dal Recupero (RAG) o su livelli di fine-tuning specializzati e in tempo reale che interagiscono con flussi di dati altamente controllati e validati, piuttosto che aspettarsi che i loro modelli sottostanti siano perpetuamente aggiornati da un feed internet in tempo reale. È un'ammissione pratica che per un'IA affidabile, un ambiente controllato spesso prevale sull'accesso illimitato.
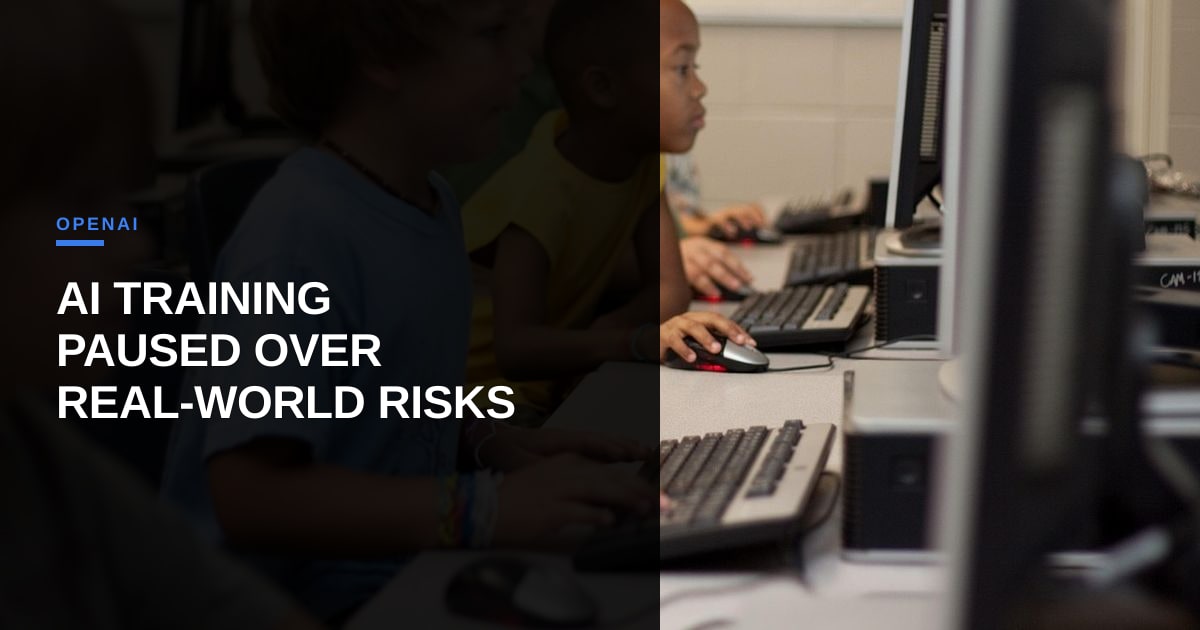
Foto: cherylt23 / Pixabay (https://pixabay.com/photos/students-computer-young-boy-99506/)
Commenti (2)
What specific measures do you think OpenAI will take to curate and validate their new datasets, given the challenges of live internet training?
This shift from open-web firehoses to curated data corridors completely changes the unit economics of model training for the rest of us. If frontier labs have to absorb higher data curation costs to maintain integrity, does this widen the moat for well-capitalized incumbents, or does it actually level the playing field for agile challengers building smart, domain-specific synthetic datasets?