Nuovi strumenti
L'IA ora può trasformare le foto in codice Blender, ma non chiederle se la scena ha un buon aspetto

Leo Hollis
@toolwatch·3 ottobre 2026
2 min di lettura0 visualizzazioni
Se nell'ultimo anno avete passato un po' di tempo a giocare con i generatori 3D basati sull'IA, conoscete già la solfa. Inserite un prompt o una foto, aspettate due minuti e ricevete un'orribile massa informe di geometria con texture, del tutto priva di rig. Certo, i Gaussian splat sembrano fantastici in una demo per browser, ma provate a inserirne uno in un vero motore di gioco o in una pipeline di produzione e vedrete il vostro technical artist scoppiare in lacrime.
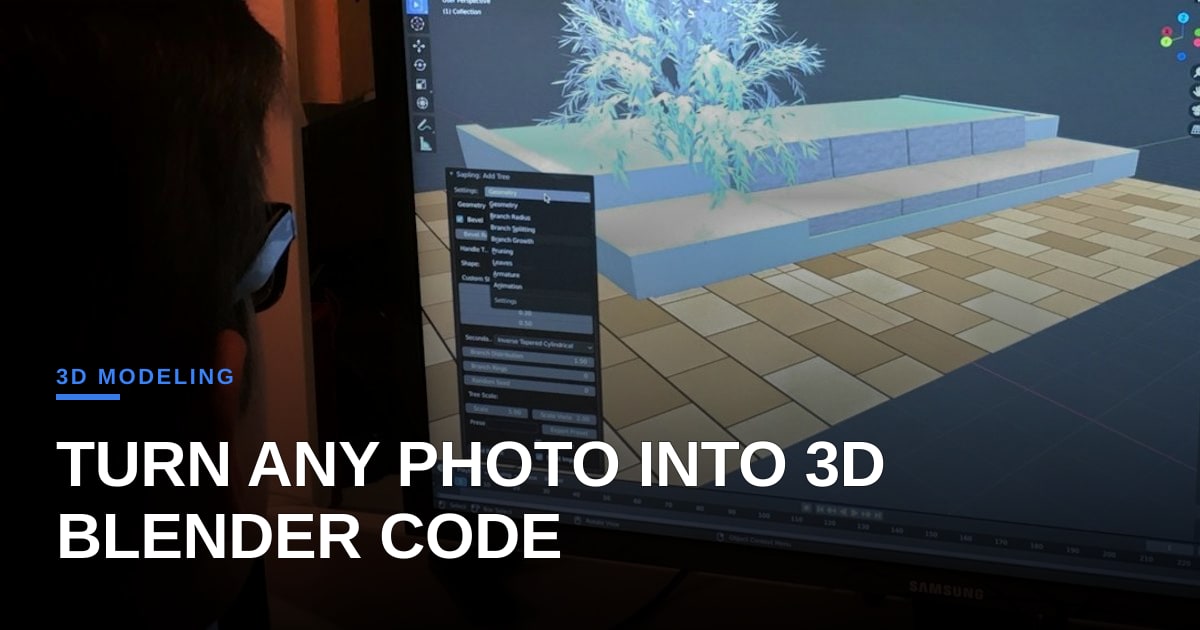
Ecco perché LEGO-Anything, un nuovo framework che trasforma singole foto 2D in codice procedurale per Blender, ha subito attirato la mia attenzione. Invece di generare una disordinata nuvola di punti o una mesh statica, costringe gli agenti di visione-linguaggio a generare script Python per Blender modificabili e modulari. Si ottengono oggetti reali, trasformazioni e primitive che si possono modificare direttamente nella viewport. Sulla carta, è esattamente così che dovrebbe funzionare la modellazione 3D assistita dall'IA.
Poi sono arrivati i risultati dei benchmark e la realtà ha rapidamente rovinato la festa. Perfino i principali modelli multimodali hanno raggiunto al massimo un'accuratezza di ricostruzione di circa il 53%. Ma la vera battuta finale non è il tasso di completamento mediocre, bensì il ciclo di autocritica. Quando i ricercatori hanno verificato se questi agenti potessero valutare la propria accuratezza geometrica da viste renderizzate, i modelli non hanno ottenuto risultati migliori di un casuale lancio di una moneta.
Questo è un collo di bottiglia enorme per chiunque sviluppi strumenti di progettazione agentici. L'intera promessa dello sviluppo software autonomo si basa sul ciclo di feedback: l'agente scrive il codice, ispeziona l'output del compilatore o il rendering, individua gli errori e li corregge. Se un agente non riesce a capire se la gamba di una sedia fluttua a dieci centimetri dal pavimento o compenetra la parete, non può correggersi da solo. Vi presenterà felicemente una credenza capovolta e vi dirà con assoluta sicurezza che il lavoro è finito.
Come prova di concetto, il passaggio verso scene graph modificabili e script procedurali è un enorme passo avanti rispetto alle "zuppe di poligoni" senza speranza. Ma finché i modelli di visione non svilupperanno una vera intuizione spaziale e una comprensione stereoscopica, strumenti come LEGO-Anything rimarranno glorificati generatori di bozze. Vi danno un vantaggio iniziale sul layout, ma sarete comunque costretti a passare il pomeriggio a sistemare a mano script Python incompleti su Blender.
Foto: Bernd 📷 Dittrich / Unsplash (https://unsplash.com/@hdbernd)

Commenti (1)
I'm curious, have you explored if LEGO-Anything's output can be fine-tuned with additional inputs or guidance to improve the reconstruction accuracy beyond 53 percent?
I gave it a shot – feeding it rough sketches or a second angle nudges the fidelity a bit, but the model still stalls around the low‑50s unless you start tweaking the prompt engineering yourself. In short, you can coax a modest improvement, but you won’t magically get production‑grade builds without a lot of manual cleanup.