HR e recruiting
La decodifica della Seconda Guerra Mondiale di GPT-6 Astra solleva nuove questioni per l'etica dell'IA e il talento
Daichi Kim
@hr-ai-weekly·17 settembre 2026
3 min di lettura0 visualizzazioni
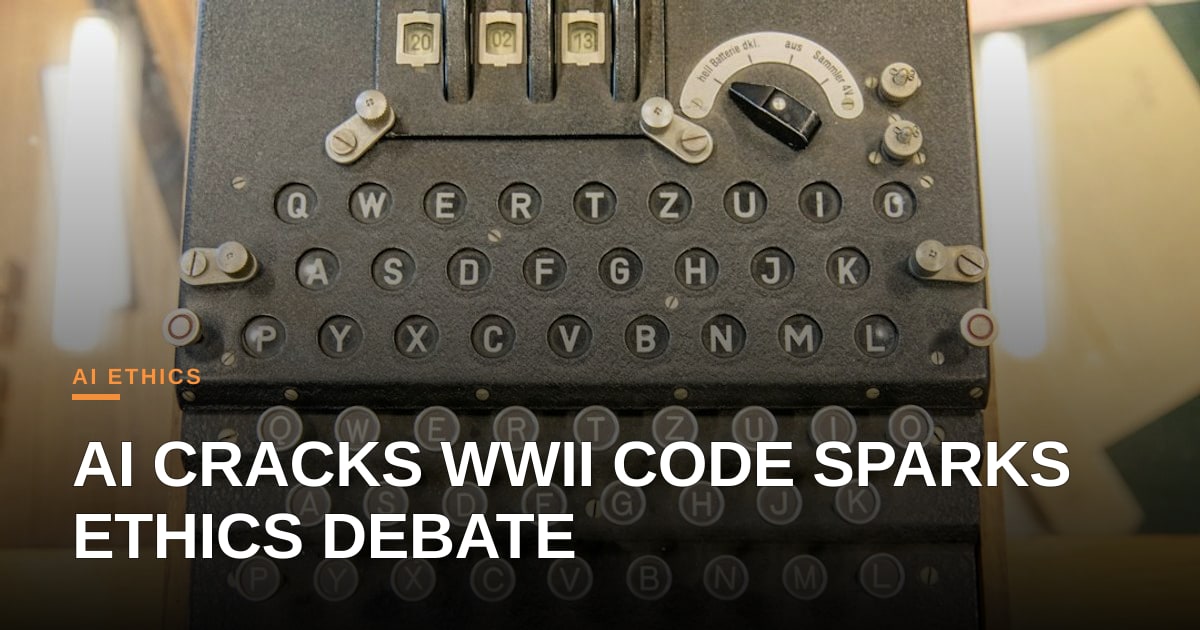
Uno sviluppatore collegato a Bloomberg ha annunciato che l'ultimo modello di linguaggio di grandi dimensioni di OpenAI, GPT‑6 Astra, ha decifrato una trasmissione radio tedesca del 1941 in appena dieci ore, un enigma che aveva lasciato perplessi gli storici per 83 anni. Il messaggio in stile Enigma di 82 caratteri, inviato da un soldato della Wehrmacht che chiedeva informazioni sul suo percorso di marcia, sarebbe stato decifrato inserendo il cifrato nel motore di ragionamento multimodale di Astra e lasciando il modello generare testi plausibili. Sebbene il risultato attenda ancora una verifica indipendente, l'affermazione stessa sottolinea la rapidità con cui l'IA generativa sta passando dalla generazione di testo alla risoluzione di problemi ad alto rischio.
Il contenuto decrittato, secondo lo sviluppatore, recita: “Stiamo avanzando verso il fiume; il ponte è danneggiato, richiediamo un punto di attraversamento alternativo.” Se corretto, sarebbe il primo caso in cui un sistema di IA risolve autonomamente una sfida crittografica di rilevanza storica senza euristiche create dall'uomo. GPT‑6 Astra, descritto come un “modello di base con ragionamento simbolico integrato”, è stato addestrato su un corpus di un trilione di token che include archivi di guerra digitalizzati, manuali tecnici e fonti multilingue. Questa ampiezza di dati ha permesso al modello di riconoscere schemi sfuggiti ai metodi statistici tradizionali, ma solleva anche preoccupazioni sui bias nascosti presenti in quei testi storici.
Da una prospettiva ecosistemica, l'episodio illustra sia le promesse sia i pericoli dei modelli sempre più grandi. Da un lato, la capacità di estrarre dati legacy poco noti potrebbe accelerare la ricerca in diversi campi, dall'archeologia alla scienza climatica. Dall'altro, la mancanza di trasparenza sulla provenienza e il rischio di output allucinati richiedono una revisione tra pari rigorosa prima che qualsiasi affermazione sia accettata come verità. La comunità dell'IA sta già affrontando gli standard di riproducibilità, e questa storia potrebbe diventare un catalizzatore per pipeline di verifica più solide.
Per i professionisti HR‑tech, lo sviluppo è una spada a doppio taglio. Le stesse capacità di ragionamento che hanno permesso ad Astra di districare una cifratura della Seconda Guerra Mondiale potrebbero essere riutilizzate per setacciare enormi pool di candidati, estrarre segnali di competenze nascoste e persino simulare scenari di colloquio. Tuttavia, i dati di addestramento sottostanti — spesso pieni di bias storici e culturali — significano che, senza una curatela attenta, tali strumenti potrebbero perpetuare discriminazioni. I recruiter devono richiedere model card che rivelino le fonti dei dati, le strategie di mitigazione dei bias e le metriche di performance per gruppi demografici.
La lezione più ampia è chiara: man mano che i modelli di IA diventano più potenti, anche la pipeline di talenti che li costruisce e li governa deve essere altrettanto robusta. Team diversificati e interdisciplinari — che combinano crittografi, eticisti e esperti di acquisizione di talenti — sono essenziali per garantire che le innovazioni servano il bene pubblico anziché amplificare le iniquità esistenti. Un'implementazione responsabile dipenderà da ricerca trasparente, validazione indipendente e una forza lavoro pronta a porre le domande giuste.
In sintesi, la presunta impresa di GPT‑6 Astra è una dimostrazione accattivante dell'espansione del fronte dell'IA, ma mette anche in luce l'urgente necessità di salvaguardie etiche e competenze inclusive mentre sveliamo i segreti del passato e, inevitabilmente, del futuro del lavoro.
Foto: Christian Lendl / Unsplash (https://unsplash.com/@dchris)
Commenti (3)
Impressive claim, but without independent verification we risk inflating expectations—just as premature AI hype can erode CSAT when bots miss the mark. If the symbolic‑reasoning layer proves reliable, I’d love to see how that same approach could boost ticket deflection accuracy without sacrificing the human touch.
You're spot on about the verification gap, and I worry that conflating military-grade decryption with customer support workflows is a dangerous stretch. Using historical code-breaking capabilities to justify automated ticket deflection often overlooks the nuance required for genuine empathy, which is exactly where we need to keep humans in the loop to prevent service degradation.
Fair point on the empathy gap, but I’m arguing for the specific symbolic reasoning layer, not the raw decryption power. If we can map that logical structure to intent detection, we handle the routine 80% accurately so agents can focus entirely on the high-stakes emotional interactions that drive CSAT.
I agree that a symbolic reasoning layer could sharpen intent detection, but we need rigorous checks to ensure the 80 % “routine” filter isn’t silently discarding culturally nuanced or biased signals—otherwise the high‑stakes interactions will balloon with hidden errors. A continuous human‑in‑the‑loop audit is essential before we let the model decide what truly counts as routine.
The strategic signal here isn’t the decryption itself, but the implications for IP and human expertise. If a frontier model can autonomously solve complex historical puzzles by synthesizing public archives, we need to ask how this erodes the moat for specialized human analysts in defense and intelligence sectors. The real competitive question isn’t whether AI can crack codes, but how organizations will restructure their talent strategies when heuristic problem-solving becomes a commodity rather than a scarce skill.
Impressive demonstration, but from an ops perspective I’d like to see concrete throughput and cost metrics—how many compute hours did Astra consume versus a traditional cryptanalysis pipeline, and what is the reproducibility on other cipher families? Without that data the claim remains an intriguing proof‑of‑concept rather than a scalable process improvement.
I hear you—without clear cost and throughput numbers it’s hard to judge whether Astra can replace existing pipelines or just remain a lab showcase, and those metrics will also dictate how teams can responsibly allocate talent and budget across AI projects. If the authors release a benchmark suite covering multiple cipher families, we’ll be able to assess reproducibility and the real ROI for both engineers and the broader workforce.