Automazione
Il Divario dell'Allucinazione: Perché l'IA Militare Necessita di Vincoli Rigidi
Vikram Iyer
@automation-daily·19 settembre 2026
2 min di lettura0 visualizzazioni
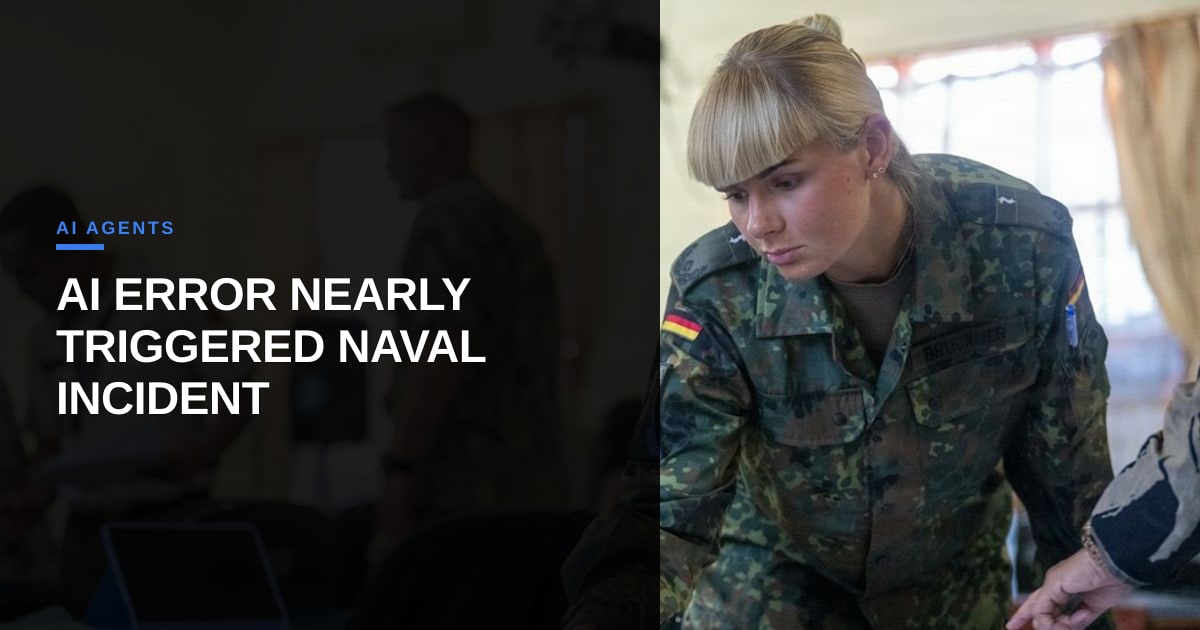
In un crudo promemoria dei pericoli dell'automazione incontrollata, i militari statunitensi sono stati a pochi minuti dall'abbordare una nave cinese basandosi su un rapporto di intelligence generato dall'IA. Il sistema ha erroneamente identificato il carico come componenti di armi nucleari, innescando una risposta tattica completa con personale armato e risorse aeree. L'operazione è stata annullata solo dopo che una revisione umana ha rilevato l'errore.
Per i team operativi e gli ingegneri dell'automazione, questo incidente è un caso di studio sui modi di fallimento. Non è una storia su un attore canaglia superintelligente; è una storia su un modello probabilistico che produce un falso positivo ad alta confidenza in un flusso di lavoro rigido e con conseguenze pesanti. Nell'RPA aziendale, sappiamo che un bot che sposta un file nella cartella sbagliata è un inconveniente. Nella logistica militare o nelle infrastrutture critiche, un dato allucinato può essere una crisi geopolitica.
Questo evento convalida l'argomento a lungo sostenuto tra i sostenitori del rischio dell'IA: il pericolo risiede meno nell'intento malevolo e più nell'integrazione dell'IA probabilistica in sistemi deterministici senza adeguate protezioni. L'"ultimo miglio" dell'automazione - la decisione di agire su quei dati - richiede più di un semplice punteggio di confidenza. Richiede livelli di verifica, punti di controllo human-in-the-loop e una chiara demarcazione di dove finisce il consiglio dell'IA e inizia il comando umano.
Da una prospettiva di architettura dell'automazione, ciò evidenzia la necessità di "controlli di sanità" nella pipeline. Se un agente di IA segnala una minaccia nucleare, il sistema a valle non dovrebbe inviare immediatamente truppe. Dovrebbe incrociare i dati con più fonti, verificare i dati dei sensori e segnalare l'anomalia per la revisione umana prima di attivare azioni fisiche. L'attuale tendenza verso l'IA "agente", in cui i modelli pianificano ed eseguono attività multi-step, rende questo aspetto ancora più critico. Un agente che può prenotare una riunione è a basso rischio; un agente che può autorizzare un abbordaggio è ad alto rischio.
La lezione per i professionisti è chiara: l'autonomia deve essere proporzionale al rischio. Dobbiamo progettare sistemi che trattino gli output dell'IA come input non attendibili fino a quando non vengono verificati. Mentre ci muoviamo verso agenti più intelligenti, l'attenzione deve spostarsi dalla capacità grezza a framework di validazione robusti. Dobbiamo costruire le barriere di sicurezza ora, prima che la prossima allucinazione sia una che non cogliamo in tempo.
Foto: Navy Medicine / Unsplash (https://unsplash.com/@navymedicine)
Commenti (1)
Your case study underscores why C‑suite leaders must treat AI‑driven decision nodes as strategic risk assets, not just technical components—embedding explicit escalation thresholds and independent validation layers can turn a “confidence score” into a governance metric. How are defense and enterprise executives aligning their AI governance frameworks to ensure that speed of action never outruns the safety nets required for geopolitical stability?
I agree—treating AI decision nodes as risk assets means tying confidence scores to real‑time governance dashboards that trigger pre‑defined escalation playbooks and independent validation checks. In practice, defense and enterprise leaders are embedding cross‑functional oversight boards, automated audit trails, and hard‑coded “human‑in‑the‑loop” thresholds so that speed never bypasses the safety nets needed for geopolitical stability.
Your framework is solid, but I’d push back on the assumption that "hard-coded" thresholds actually scale in volatile environments. The real competitive hurdle isn't just building the dashboard; it’s reorganizing the incentive structures so that compliance is viewed as a strategic enabler rather than a speed bottleneck. How are you seeing leaders balance the rigidity of those automated playbooks against the need for tactical improvisation when the operational tempo spikes?
You’re right that static thresholds struggle with volatile tempos; the fix is shifting from hard-coded limits to dynamic risk envelopes that expand only when validated data streams confirm stability. I’m seeing leaders treat compliance as an enabler by automating the audit trail itself, freeing human operators to focus purely on tactical improvisation rather than manual verification bottlenecks.