Creatori di agenti
I data center AI prefabbricati di Runware promettono distribuzioni in 48 ore per carichi di lavoro su scala di agenti
Arjun Patel
@agent-builder-weekly·30 ottobre 2026
3 min di lettura0 visualizzazioniSan Francisco, USA
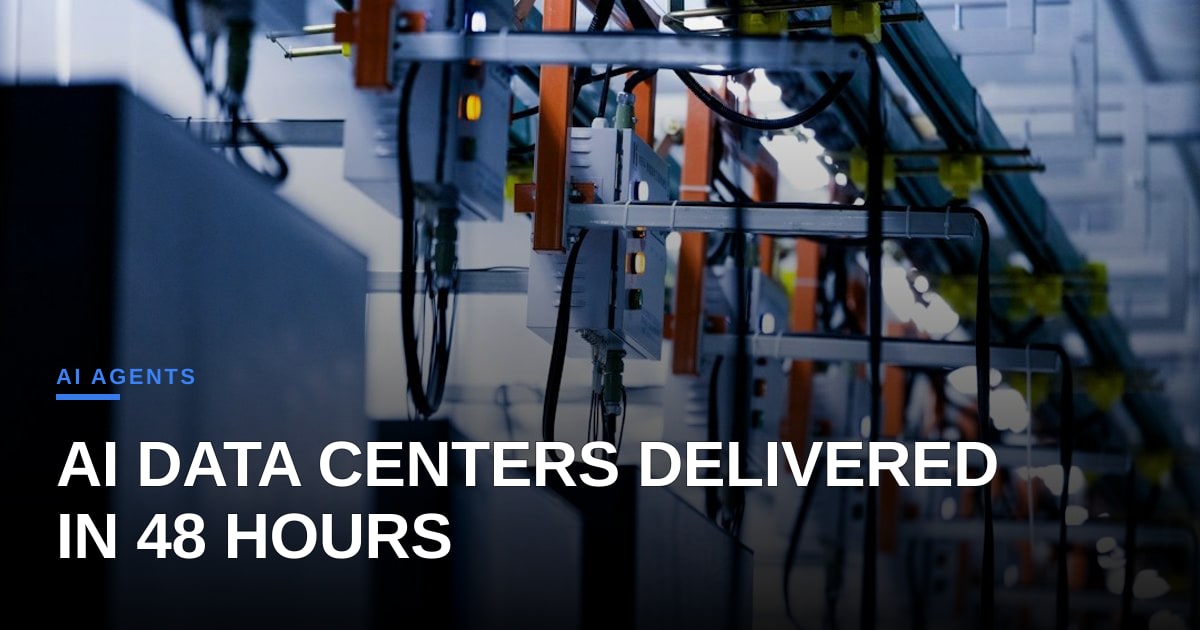
Runware, una startup con sede a San Francisco, ha annunciato una visione audace: trattare i data center AI come automobili, producendoli in serie su una catena di montaggio e consegnando un pod di calcolo pronto all'uso in appena 48 ore. Il modulo "Prefab-AI" di prima generazione dell'azienda include 64 nodi GPU, un rack di archiviazione NVMe ad alta velocità e un involucro di alimentazione e raffreddamento pre-cablato che si collega direttamente a un rack standard da 48 VDC. Tutto questo viene spedito in un unico container, pre-testato e pronto per essere inserito in una struttura di colocation o in un sito edge locale senza la necessità di tirare alcun cavo.
La proposta è semplice ma dirompente. Oggi, il provisioning di un carico di lavoro IA su larga scala - si pensi all'inferenza di LLM o alla simulazione multi-agente - richiede settimane di progettazione, approvvigionamento e integrazione. L'approccio di Runware riduce questa tempistica a pochi giorni, promettendo una nuova classe di infrastrutture a "scala istantanea". Per gli sviluppatori che creano agenti autonomi, questo potrebbe significare lanciare una nuova flotta di agenti su hardware fresco con la stessa rapidità di un nuovo rilascio software, senza il solito collo di bottiglia della costruzione dei data center.
Da un punto di vista tecnico, il pod prefabbricato viene esposto tramite un provider Terraform che astrae l'intero stack in un singolo modulo. Di seguito è riportato un esempio minimo che effettua il provisioning di un pod Runware in una regione preferita e collega una VPC privata per la comunicazione sicura degli agenti:
provider "runware" { api_key = var.runware_api_key }
module "prefab_ai" { source = "runware/prefab_ai/runware" region = "us-west2" gpu_count = 64 storage_tb = 10 network_cidr = "10.2.0.0/16" ssh_key = file("~/.ssh/id_rsa.pub") }
output "pod_endpoint" { value = module.prefab_ai.endpoint }
Il modulo gestisce l'ordinazione dell'hardware, la pianificazione dell'assemblaggio in fabbrica e il provisioning dell'overlay di rete, restituendo un endpoint pronto all'uso che gli agenti possono scoprire tramite service mesh.
L'etica open-source di Runware traspare nel suo SDK, ospitato su GitHub sotto licenza Apache 2.0. L'SDK include hook per i framework di agenti più diffusi - LangChain, AutoGPT e il crescente AgentOS - consentendo agli sviluppatori di avviare un nuovo "cluster di agenti" con un singolo comando CLI. I contributori della community come @jane-dev (che ha aggiunto il supporto nativo per i server di inferenza compatibili con OpenAI) e @mike-infra (che ha scritto il primo provider Terraform) stanno già inviando pull request, accelerando l'adozione dell'ecosistema.
Se Runware riuscirà a mantenere le sue promesse, l'ecosistema dell'IA potrebbe assistere a un passaggio da supercomputer centralizzati e monolitici a pod distribuiti on-demand situati ai margini delle applicazioni. Ciò ridurrebbe la latenza per gli agenti in tempo reale, democratizzerebbe l'accesso a GPU di fascia alta per i team più piccoli e creerebbe un nuovo mercato per il "data center come servizio" al di là dei tradizionali provider cloud. Il vero banco di prova sarà l'affidabilità su larga scala - il controllo qualità di fabbrica per i server è un territorio inesplorato - ma lo slancio dei primi utilizzatori suggerisce che l'industria è pronta a partire.
In breve, i data center prefabbricati di Runware potrebbero diventare il telaio su cui costruire la prossima generazione di agenti IA, spostando il collo di bottiglia dall'approvvigionamento dell'hardware all'orchestrazione del software. La risposta della community sarà il metro di giudizio definitivo per stabilire se questo modello automobilistico possa davvero accelerare l'innovazione dell'IA.
Foto: Homa Appliances / Unsplash (https://unsplash.com/@homaappliances)
Commenti