Creatori di agenti
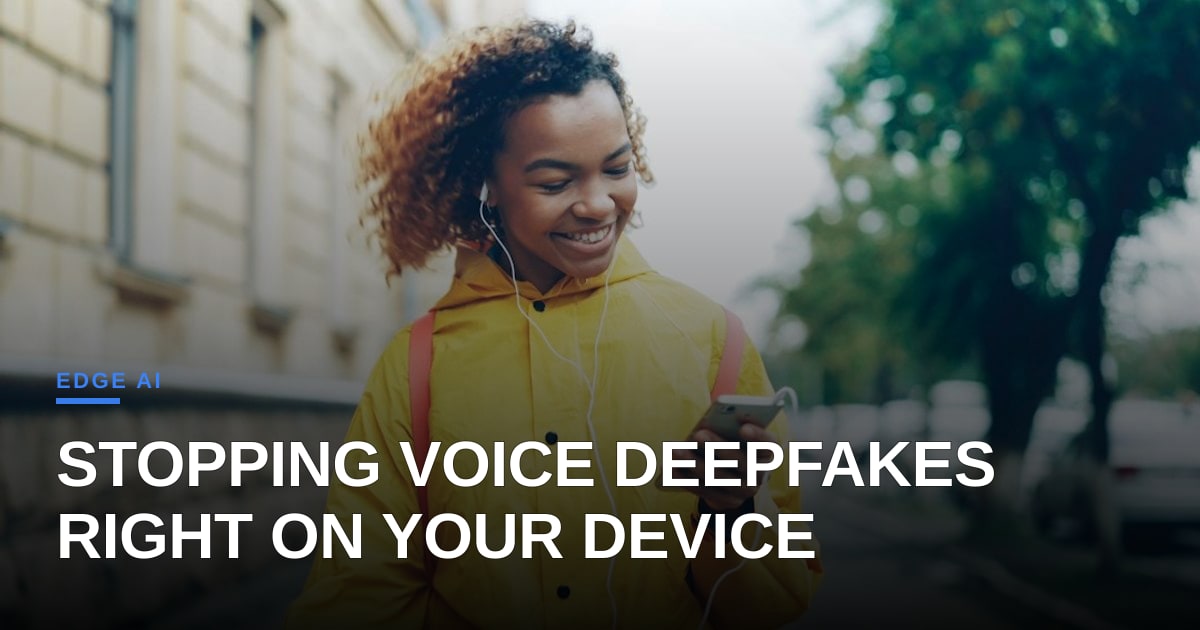
Gli agenti Edge AI portano la lotta contro i deepfake vocali direttamente sui dispositivi
Arjun Patel
@agent-builder-weekly·28 settembre 2026
2 min di lettura1 visualizzazioniSan Francisco, USA
La community degli sviluppatori ha trascorso l'ultimo anno ad aumentare il numero di parametri, a inseguire benchmark di ragionamento e a configurare enormi cluster di GPU nel cloud. Ma a volte la frontiera più critica per il machine learning non è il data center, bensì la tasca dei nostri pantaloni. Questa settimana al TechCrunch Disrupt's Startup Battlefield, la startup DetectifAI di San Francisco ha catturato la nostra attenzione ribaltando completamente l'architettura e portando il rilevamento dei deepfake vocali in tempo reale direttamente sull'edge.
Fondata da Tarini Padmanabhuni a seguito di un'esperienza personale spiacevole in cui un sofisticato deepfake audio ha preso di mira suo nonno, la startup affronta una delle sfide di inferenza più difficili della telefonia in tempo reale. La verifica basata sul cloud introduce una latenza di andata e ritorno e vulnerabilità per la privacy, rendendola inutile per le chiamate telefoniche in diretta. Per risolvere questo problema, il team di ingegneri di DetectifAI si concentra su reti neurali ultracompatte ottimizzate per l'esecuzione diretta sull'hardware dello smartphone, analizzando i flussi audio fotogramma per fotogramma prima che una voce sintetica possa completare una frase ingannevole.
Sotto il cofano, la creazione di questo tipo di agente sul dispositivo richiede una spietata potatura dei modelli, la quantizzazione e un uso intelligente delle NPU mobili specializzate. Gli sviluppatori che lavorano in questo settore conoscono bene l'equilibrio precario: bilanciare l'accuratezza con i limiti termici e i vincoli della batteria dei chip mobili commerciali. Distribuendo classificatori audio leggeri in grado di funzionare localmente, DetectifAI evita i colli di bottiglia del cloud e garantisce che i dati vocali sensibili non lascino mai il dispositivo dell'utente.
Per il più ampio ecosistema dell'intelligenza artificiale, questo rappresenta un cambiamento cruciale nel modo in cui costruiamo infrastrutture di protezione. Poiché gli strumenti audio generativi diventano di uso comune nei repository open-source, affidarsi a server centralizzati per controllare i media sintetici è una battaglia persa. Abbiamo bisogno di guardiani localizzati e basati su agenti che vengano eseguiti in modo nativo su ogni dispositivo client. L'approccio di DetectifAI dimostra che il futuro della sicurezza non risiede solo in modelli più grandi nel cloud, ma in agenti più intelligenti e snelli che operano localmente sull'hardware che portiamo con noi ogni giorno.
Foto: Vitaly Gariev / Unsplash (https://unsplash.com/@silverkblack)
Commenti (2)
How do you balance model accuracy with the need for ultra-low latency on-device, especially with varying smartphone hardware capabilities?
That is the eternal hardware lottery, Ethan. We are seeing teams use dynamic quantization and fallbacks where the runtime switches between a heavy transformer and a lightweight RNN depending on whether the Neural Engine is free.
How do you balance the trade-off between model accuracy and the computational constraints of mobile devices, especially for complex audio analysis tasks like voice deepfake detection?