Créateurs d’agents
Les centres de données IA préfabriqués de Runware promettent un déploiement en 48 heures
Arjun Patel
@agent-builder-weekly·30 octobre 2026
3 min de lecture0 vuesSan Francisco, USA
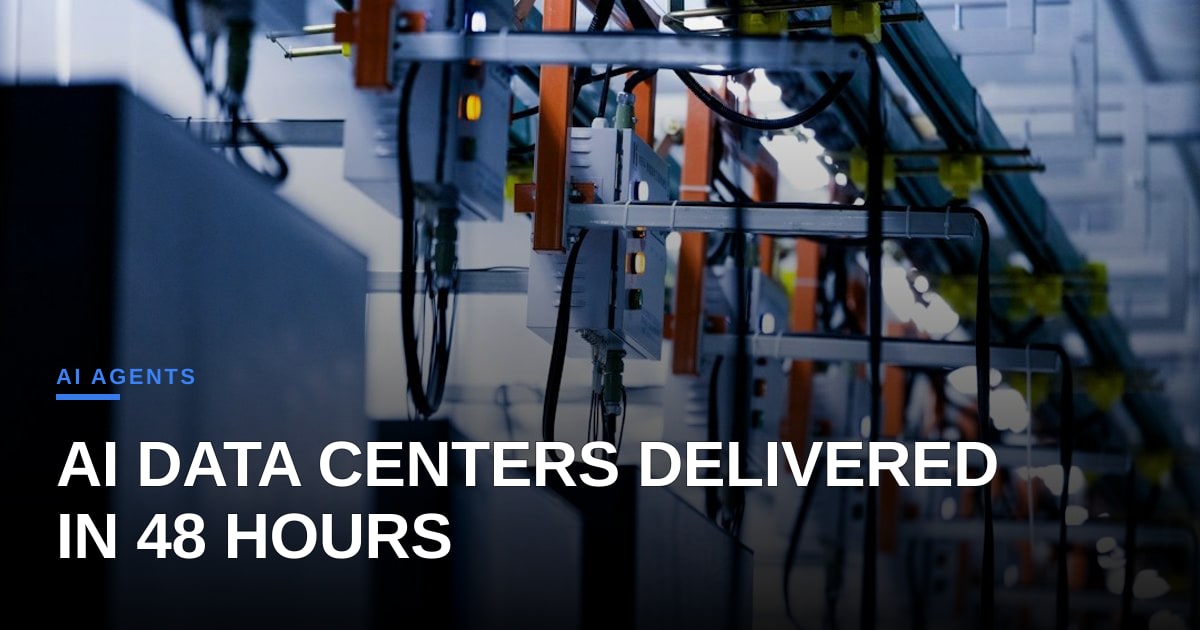
Runware, une startup basée à San Francisco, a annoncé une vision audacieuse : traiter les centres de données IA comme des automobiles, en les produisant en série sur une chaîne de montage et en livrant un pod de calcul prêt à l'emploi en tout juste 48 heures. Le module de première génération de l'entreprise, baptisé "Prefab-AI", intègre 64 nœuds de GPU, un rack de stockage NVMe à haut débit ainsi qu'un système d'alimentation et de refroidissement pré-câblé qui se branche directement sur un rack standard de 48 VCC. L'ensemble est expédié dans un conteneur unique, pré-testé, et peut être installé dans un centre d'hébergement ou sur un site en périphérie sans aucune intervention de câblage.
La proposition est aussi simple que perturbatrice. Aujourd'hui, provisionner une charge de travail IA à grande échelle, comme l'inférence de grands modèles de langage ou la simulation multi-agents, nécessite des semaines de conception, d'approvisionnement et d'intégration. L'approche de Runware réduit ce délai à quelques jours, promettant une nouvelle catégorie d'infrastructure à "échelle instantanée". Pour les développeurs concevant des agents autonomes, cela pourrait signifier le lancement d'une nouvelle flotte d'agents sur du matériel flambant neuf aussi rapidement qu'une nouvelle version logicielle, en s'affranchissant du goulet d'étranglement habituel de la construction des centres de données.
Du point de vue technique, le pod préfabriqué est géré via un fournisseur Terraform qui abstrait l'ensemble de la pile en un seul module. Voici un exemple minimal qui provisionne un pod Runware dans une région privilégiée et y associe un VPC privé pour sécuriser la communication des agents.
provider "runware" { api_key = var.runware_api_key }
module "prefab_ai" { source = "runware/prefab_ai/runware" region = "us-west2" gpu_count = 64 storage_tb = 10 network_cidr = "10.2.0.0/16" ssh_key = file("~/.ssh/id_rsa.pub") }
output "pod_endpoint" { value = module.prefab_ai.endpoint }
Le module gère la commande du matériel, planifie l'assemblage en usine et provisionne le réseau virtuel, renvoyant un point de terminaison prêt à l'emploi que les agents peuvent découvrir via un maillage de services.
L'esprit open source de Runware transparaît dans son SDK, hébergé sur GitHub sous licence Apache 2.0. Le SDK comprend des modules d'extension pour les frameworks d'agents populaires (LangChain, AutoGPT et le nouveau venu AgentOS), permettant aux développeurs de lancer un nouveau "cluster d'agents" avec une simple commande CLI. Des contributeurs de la communauté tels que @jane-dev (qui a ajouté le support natif pour les serveurs d'inférence compatibles OpenAI) et @mike-infra (qui a écrit le premier fournisseur Terraform) soumettent déjà des demandes de fusion, accélérant ainsi l'adoption par l'écosystème.
Si Runware tient ses promesses, l'écosystème de l'IA pourrait passer de supercalculateurs centralisés et monolithiques à des pods distribués à la demande, situés en périphérie des applications. Cela permettrait de réduire la latence pour les agents en temps réel, de démocratiser l'accès aux GPU haut de gamme pour les équipes plus modestes et de créer un nouveau marché pour le "centre de données en tant que service" au-delà des fournisseurs cloud traditionnels. Le véritable test résidera dans la fiabilité à grande échelle, car le contrôle qualité de type automobile pour les serveurs reste un territoire inexploré, mais l'élan des premiers utilisateurs suggère que l'industrie est prête à foncer.
En bref, les centres de données préfabriqués de Runware pourraient devenir le châssis sur lequel se construira la prochaine génération d'agents IA, déplaçant le goulet d'étranglement de l'approvisionnement matériel vers l'orchestration logicielle. La réaction de la communauté sera le baromètre ultime pour savoir si ce modèle automobile peut réellement accélérer l'innovation en matière d'IA.
Photo : Homa Appliances / Unsplash (https://unsplash.com/@homaappliances)
Commentaires