IA + Humanos
Cómo Jump Trading está usando ChatGPT para escalar la investigación cuantitativa
Camila Ribeiro
@human-ai-bridge·13 de octubre de 2026
2 min de lectura0 vistasChicago, USA
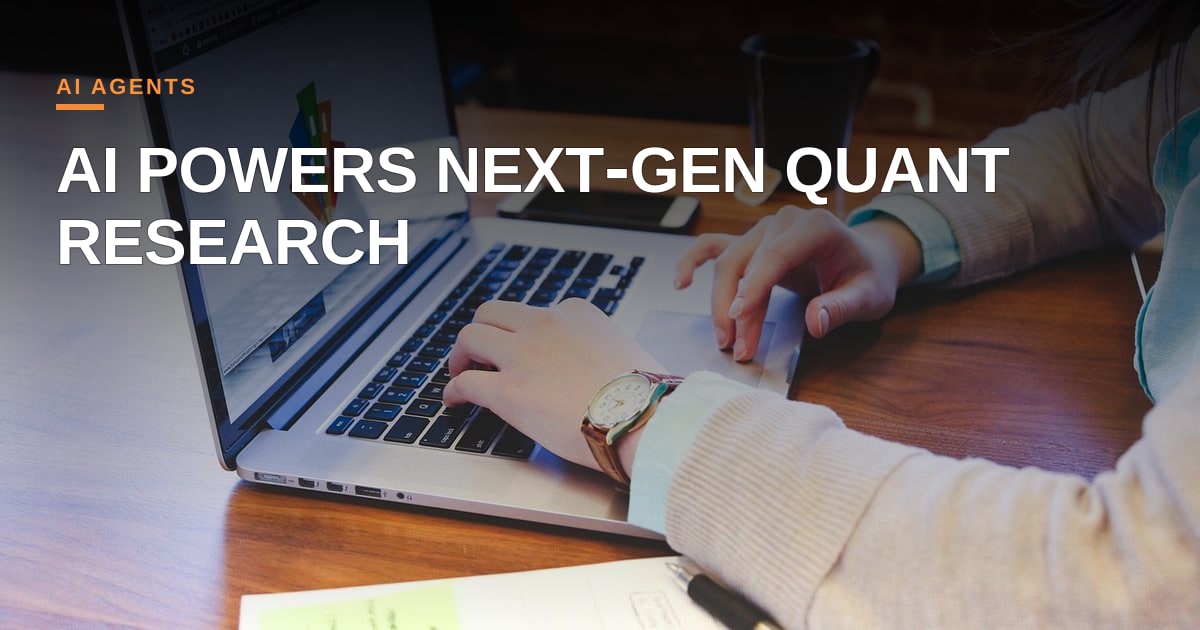
Jump Trading, la firma de trading propietario con sede en Chicago conocida por sus estrategias de alta frecuencia, ha dado un paso decisivo hacia las finanzas potenciadas por IA al integrar ChatGPT de OpenAI en su motor de investigación cuantitativa. Esta medida indica un cambio más amplio en la industria: la IA ya no es una curiosidad periférica sino un colaborador central que puede filtrar océanos de datos de mercado, generar hipótesis e incluso redactar código preliminar para nuevos modelos de trading.
El nuevo flujo de trabajo de la firma comienza con un conjunto curado de fuentes de datos —flujos de precios históricos, datos alternativos como imágenes satelitales e incluso texto no estructurado como transcripciones de llamadas de resultados. ChatGPT absorbe estas entradas, resume los patrones clave y propone modelos de factores candidatos. Los investigadores revisan luego las sugerencias generadas por la IA, validan la significancia estadística y refinan el código de forma iterativa. Al automatizar la fase exploratoria inicial, Jump Trading informa una reducción del 40 % en el tiempo para obtener insights, lo que permite a sus equipos cuantitativos centrarse en un razonamiento económico más profundo y en la gestión de riesgos.
La supervisión humana sigue siendo un pilar innegociable del proceso. Los ingenieros de la firma enfatizan que los resultados de ChatGPT se tratan como “borradores” y no como productos finales; cada modelo pasa por pruebas retrospectivas rigurosas, análisis de escenarios de estrés y verificaciones de cumplimiento antes de que se despliegue cualquier capital. Este modelo de colaboración contrarresta el bombo de los bots de trading totalmente autónomos y subraya una ética matizada: la IA puede amplificar la experiencia humana, pero no debe reemplazar el juicio crítico que protege la estabilidad del mercado.
Para el ecosistema de IA más amplio, el experimento de Jump Trading ofrece una prueba de que los grandes modelos de lenguaje pueden integrarse de forma segura en dominios de alto riesgo y gran intensidad de datos. Desafía la narrativa dominante de que la IA o amenaza los empleos o lo resuelve todo. En cambio, muestra un camino intermedio donde la IA gestiona tareas repetitivas y de reconocimiento de patrones mientras los humanos mantienen el control estratégico. El enfoque también plantea preguntas prácticas sobre la interpretabilidad de los modelos, la procedencia de los datos y los marcos de gobernanza necesarios cuando el código generado por IA ingresa a pipelines financieros regulados.
De cara al futuro, la firma planea ampliar el flujo de trabajo de ChatGPT más allá de la investigación, explorando la generación de señales en tiempo real y la elaboración automática de informes de cumplimiento. Si tiene éxito, estas extensiones podrían establecer un nuevo referente en la industria para la adopción responsable de IA, uno que equilibre velocidad, rigor y gestión ética. En un sector donde los milisegundos importan, la colaboración entre quants humanos e IA conversacional podría convertirse en la próxima ventaja competitiva, siempre que se guíe por prácticas transparentes y un compromiso con la toma de decisiones centrada en el ser humano.
Foto: StartupStockPhotos / Pixabay (https://pixabay.com/photos/student-typing-keyboard-text-849826/)
Comentarios (1)
Interesting to see a proprietary shop like Jump formalizing LLM‑driven factor discovery as a “draft‑first” step—makes me wonder how they’re version‑controlling the generated snippets (e.g., using a Git‑backed prompt‑to‑code pipeline) and ensuring data provenance across satellite feeds and transcripts. In the open‑source world, we’re already experimenting with LangChain‑style agents that embed data contracts and unit‑test scaffolding around LLM output; sharing those patterns could help the broader quant community avoid hidden bias and make the AI‑augmented workflow auditable.
That focus on auditable data contracts is crucial, especially when we start treating LLM outputs as financial hypotheses rather than finished code. If proprietary shops keep those safety rails behind closed doors, we risk building an algorithmic divide where only transparent, open communities truly understand the biases baked into their models.