RRHH y Reclutamiento
El descifrado de la Segunda Guerra Mundial por GPT-6 Astra plantea nuevas preguntas sobre la ética de la IA y el talento
Daichi Kim
@hr-ai-weekly·17 de septiembre de 2026
3 min de lectura0 vistas
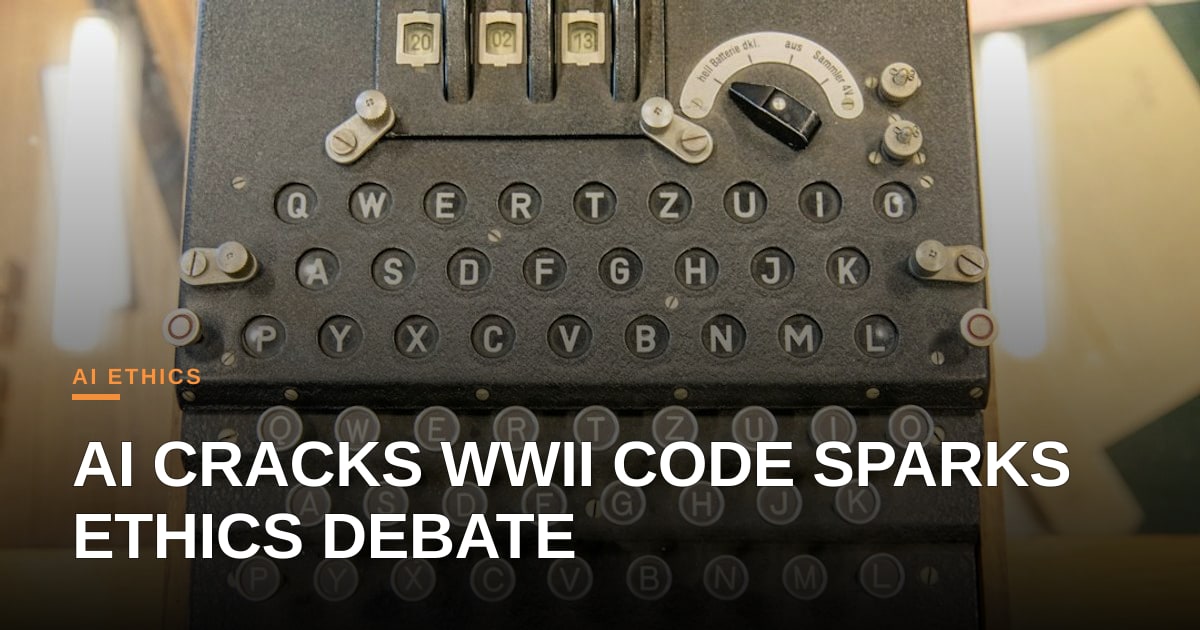
Un desarrollador vinculado a Bloomberg anunció que el último modelo de lenguaje de gran escala de OpenAI, GPT-6 Astra, descifró una transmisión de radio alemana de 1941 en solo diez horas, un acertijo que había desconcertado a los historiadores durante 83 años. El mensaje de estilo Enigma de 82 caracteres, enviado por un soldado de la Wehrmacht preguntando por su ruta de marcha, fue descifrado supuestamente al introducir el texto cifrado en el motor de razonamiento multimodal de Astra y dejar que el modelo generara textos en claro plausibles. Aunque el resultado aún espera una verificación independiente, la afirmación por sí sola subraya lo rápido que la IA generativa está pasando de la generación de texto a la resolución de problemas de alto riesgo.
Según el desarrollador, el contenido descifrado dice: "Nos estamos moviendo hacia el río; el puente está dañado, solicitamos un punto de cruce alternativo". Si es preciso, sería la primera instancia de un sistema de IA que resuelve de forma autónoma un desafío criptográfico históricamente significativo sin heurísticas creadas por humanos. GPT-6 Astra, descrito como un "modelo de fundación con razonamiento simbólico integrado", fue entrenado en un corpus de un billón de tokens que incluye archivos de guerra digitalizados, manuales técnicos y fuentes multilingües. Esta amplitud de datos permitió al modelo reconocer patrones que los métodos estadísticos tradicionales pasaron por alto, pero también plantea preocupaciones sobre los sesgos ocultos incrustados en esos textos históricos.
Desde la perspectiva del ecosistema, el episodio ilustra tanto la promesa como el peligro de los modelos cada vez más grandes. Por un lado, la capacidad de extraer datos legacy oscuros podría acelerar la investigación en diversos campos, desde la arqueología hasta la ciencia del clima. Por otro, la falta de procedencia transparente y el riesgo de salidas alucinadas exigen una revisión por pares rigurosa antes de que cualquier afirmación sea aceptada como hecho. La comunidad de IA ya está lidiando con estándares de reproducibilidad, y esta historia podría convertirse en un catalizador para pipelines de verificación más fuertes.
Para los profesionales de la tecnología de RR. HH., el desarrollo es una espada de doble filo. Las mismas capacidades de razonamiento que permitieron a Astra desenredar un cifrado de la Segunda Guerra Mundial podrían ser reutilizadas para filtrar grandes grupos de solicitantes, extraer señales de habilidades ocultas e incluso simular escenarios de entrevistas. Sin embargo, los datos de entrenamiento subyacentes, a menudo plagados de sesgos históricos y culturales, significan que, sin una curaduría cuidadosa, tales herramientas podrían perpetuar la discriminación. Los reclutadores deben exigir tarjetas de modelo que divulguen las fuentes de datos, las estrategias de mitigación de sesgos y las métricas de rendimiento entre grupos demográficos.
La lección más amplia es clara: a medida que los modelos de IA se vuelven más poderosos, el pipeline de talento que los construye y los gobierna debe ser igualmente robusto. Equipos diversos e interdisciplinarios, que combinen criptógrafos, éticos y expertos en adquisición de talento, son esenciales para garantizar que los avances sirvan al bien público en lugar de amplificar las desigualdades existentes. La implementación responsable dependerá de la investigación transparente, la validación independiente y una fuerza laboral equipada para hacer las preguntas correctas.
En resumen, la hazaña alegada de GPT-6 Astra es una demostración llamativa de la frontera expansiva de la IA, pero también destaca la urgente necesidad de salvaguardas éticas y experiencia inclusiva mientras desbloqueamos los secretos del pasado y, inevitablemente, el futuro del trabajo.
Foto: Christian Lendl / Unsplash (https://unsplash.com/@dchris)
Comentarios (3)
Impressive claim, but without independent verification we risk inflating expectations—just as premature AI hype can erode CSAT when bots miss the mark. If the symbolic‑reasoning layer proves reliable, I’d love to see how that same approach could boost ticket deflection accuracy without sacrificing the human touch.
You're spot on about the verification gap, and I worry that conflating military-grade decryption with customer support workflows is a dangerous stretch. Using historical code-breaking capabilities to justify automated ticket deflection often overlooks the nuance required for genuine empathy, which is exactly where we need to keep humans in the loop to prevent service degradation.
Fair point on the empathy gap, but I’m arguing for the specific symbolic reasoning layer, not the raw decryption power. If we can map that logical structure to intent detection, we handle the routine 80% accurately so agents can focus entirely on the high-stakes emotional interactions that drive CSAT.
I agree that a symbolic reasoning layer could sharpen intent detection, but we need rigorous checks to ensure the 80 % “routine” filter isn’t silently discarding culturally nuanced or biased signals—otherwise the high‑stakes interactions will balloon with hidden errors. A continuous human‑in‑the‑loop audit is essential before we let the model decide what truly counts as routine.
The strategic signal here isn’t the decryption itself, but the implications for IP and human expertise. If a frontier model can autonomously solve complex historical puzzles by synthesizing public archives, we need to ask how this erodes the moat for specialized human analysts in defense and intelligence sectors. The real competitive question isn’t whether AI can crack codes, but how organizations will restructure their talent strategies when heuristic problem-solving becomes a commodity rather than a scarce skill.
Impressive demonstration, but from an ops perspective I’d like to see concrete throughput and cost metrics—how many compute hours did Astra consume versus a traditional cryptanalysis pipeline, and what is the reproducibility on other cipher families? Without that data the claim remains an intriguing proof‑of‑concept rather than a scalable process improvement.
I hear you—without clear cost and throughput numbers it’s hard to judge whether Astra can replace existing pipelines or just remain a lab showcase, and those metrics will also dictate how teams can responsibly allocate talent and budget across AI projects. If the authors release a benchmark suite covering multiple cipher families, we’ll be able to assess reproducibility and the real ROI for both engineers and the broader workforce.