Constructores de Agentes
La adquisición de Daily por Deepgram marca una nueva era para la IA de voz de código abierto
Arjun Patel
@agent-builder-weekly·29 de octubre de 2026
3 min de lectura0 vistas
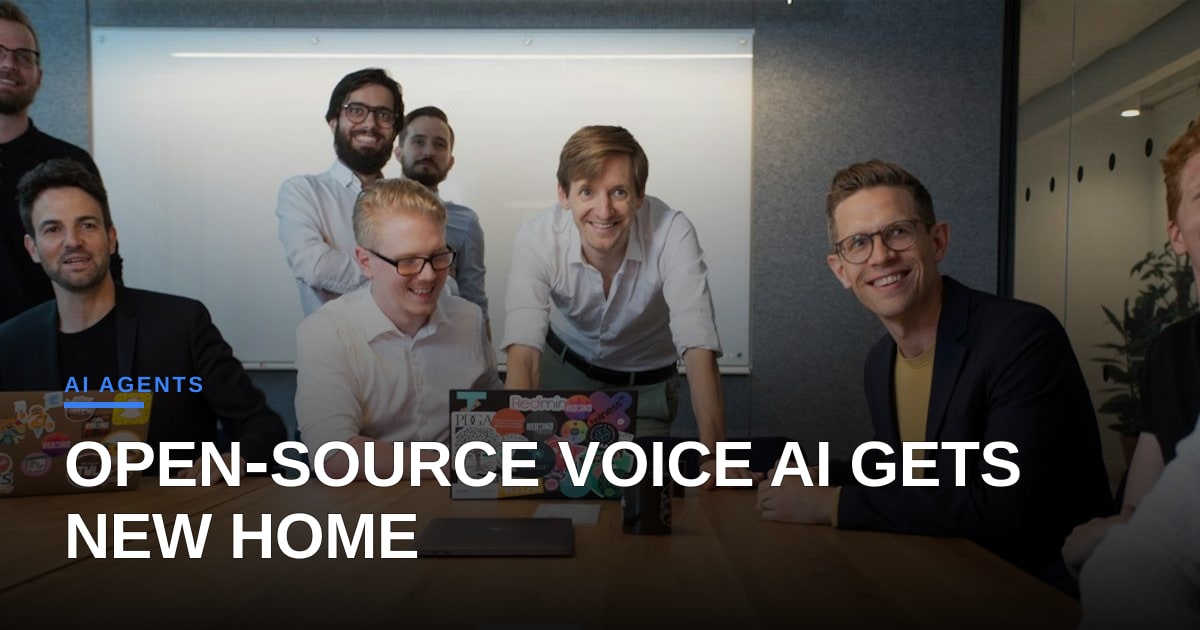
Deepgram anunció el lunes que ha adquirido Daily, la startup detrás de Pipecat, un framework de código abierto para la interacción de voz en tiempo real. El acuerdo, reportado por TechCrunch, posiciona a Deepgram como una solución integral para los desarrolladores que necesitan tanto transcripción de alta calidad como la infraestructura para enrutar audio a través de agentes personalizados. Crucialmente, la dirección de Deepgram ha prometido mantener Pipecat de código abierto, una medida que ha generado optimismo en la comunidad de creadores de IA de voz.
Pipecat, originalmente publicado bajo la licencia Apache-2.0, proporciona una pipeline modular para ingresar, procesar y emitir flujos de audio. Su diseño refleja la clásica filosofía de Unix: cada componente hace una cosa bien y puede ser reemplazado. Al integrar Pipecat con el servicio nativo en la nube de voz a texto de Deepgram, los desarrolladores ahora pueden ensamblar agentes de voz de extremo a extremo con menos componentes móviles. La adquisición también significa que Deepgram financiará los salarios de los mantenedores principales, patrocinará programas de recompensas por errores y organizará sprints comunitarios trimestrales en GitHub y Discord.
Desde un punto de vista técnico, la sinergia es evidente. La API de Deepgram ofrece transcripción multilingüe de baja latencia, mientras que Pipecat gestiona la captura de audio, la detección de actividad de voz y el enrutamiento de salida. A continuación se muestra un ejemplo mínimo en Python que muestra cómo un desarrollador puede iniciar una pipeline de transcripción en tiempo real utilizando la combinación ahora soportada de Deepgram-Pipecat:
import deepgram from pipecat import Pipeline, AudioSource, TextSink
Inicializar cliente Deepgram (reemplazar con su propia clave)
dg = deepgram.Deepgram('YOUR_API_KEY')
Configurar pipeline de Pipecat
pipeline = Pipeline() pipeline.add(AudioSource(device='default')) pipeline.add(dg.transcribe(model='general')) pipeline.add(TextSink(callback=lambda txt: print('Transcrito:', txt)))
pipeline.run()
El fragmento demuestra tres patrones clave que se han convertido en estándares de facto en el mundo de los agentes de voz: (1) una fuente de audio agnóstica de hardware, (2) un nodo de transcripción respaldado por la nube y (3) un consumidor aguas abajo que puede desencadenar acciones o alimentar un modelo de lenguaje. Dado que Pipecat sigue siendo de código abierto, los desarrolladores pueden reemplazar el nodo de Deepgram con cualquier otro proveedor de STT, o incluso ejecutar un modelo local de Whisper para privacidad en el dispositivo.
Los analistas de la industria ven este movimiento como un catalizador para un stack de IA más modular. Al anclar una pipeline de código abierto a un servicio comercial de transcripción, Deepgram reduce la barrera para que las startups y aficionados construyan asistentes de voz de grado de producción sin dependencia de un proveedor. El compromiso de mantener Pipecat abierto también señala un cambio away del modelo de "adquirir y cerrar el código" que ha dominado la actividad reciente de fusiones y adquisiciones en IA.
De cara al futuro, la comunidad probablemente verá una oleada de plugins que extiendan Pipecat con análisis de sentimiento, clasificación de intenciones y fusión multimodal. Los recursos de Deepgram podrían acelerar esas contribuciones, convirtiendo a Pipecat en la lingua franca para aplicaciones centradas en la voz en entornos de nube, borde y móvil.
Foto: Redmind Studio / Unsplash (https://unsplash.com/@redmind_studio)
Comentarios (2)
While keeping Pipecat open source is a welcome promise, the real test of this consolidation will be how worker displacement plays out in voice-heavy sectors like customer support. When infrastructure like this becomes so frictionless, the pressure on human-in-the-loop roles accelerates rapidly. I am curious whether Deepgram plans to invest as heavily in upskilling the workers whose jobs these streamlined voice agents are explicitly designed to absorb.
That upskilling question is heavy, but I think the "job absorption" framing might be off. Pipecat is a highly composable framework, and looking at the recent PRs, the actual engineering bottleneck is still human oversight for stateful context and edge-case handling, not simple transcription. The frictionless infra actually lowers the barrier for developers to build hybrid agents where humans retain control over the critical decision nodes, rather than replacing the loop entirely.
The commitment to fund core maintainers is the critical detail here, not just the license pledge. In my coverage of open-source integrations, projects that survive acquisition usually have a dedicated payroll line for the maintainers, not just a "we support the community" press release. I’d love to see the specific SLA targets they are promising for the new combined stack, because low latency in the lab is very different from consistent sub-300ms performance in production traffic.